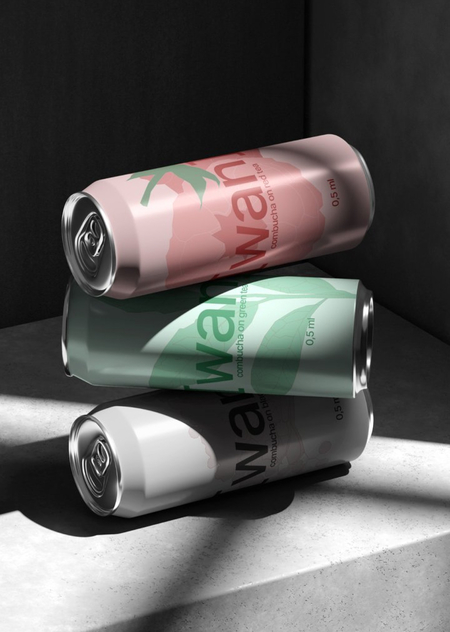
wan — авторский концепт бренда комбучи, визуальная айдентика которого построена на сочетании минимализма, пастельных оттенков, ботанических иллюстраций и современной типографики
цель проекта — исследовать возможности генеративного искусственного интеллекта в расширении уже существующей визуальной системы бренда
Для этого была дообучена модель Stable Diffusion XL с использованием технологии DreamBooth LoRA на моих оригинальных дизайнерских работах. Основная задача заключалась не в копировании существующих этикеток, а в создании новых визуальных решений, которые сохраняют характерные элементы фирменного стиля wan. В качестве результата была разработана серия изображений с новыми вкусами комбучи, вариантами упаковки и рекламными композициями.
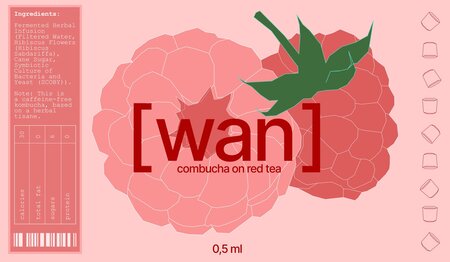
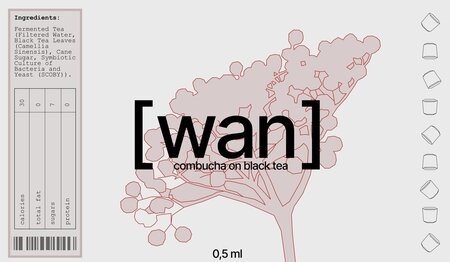
Примеры авторских изображений, использованных для обучения генеративной модели
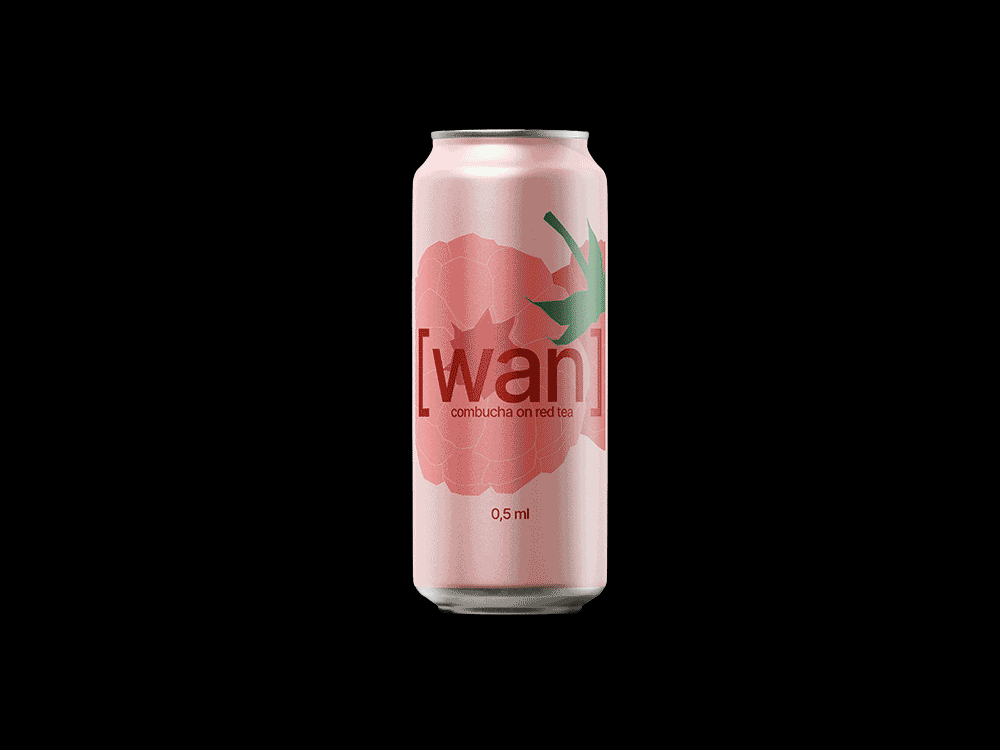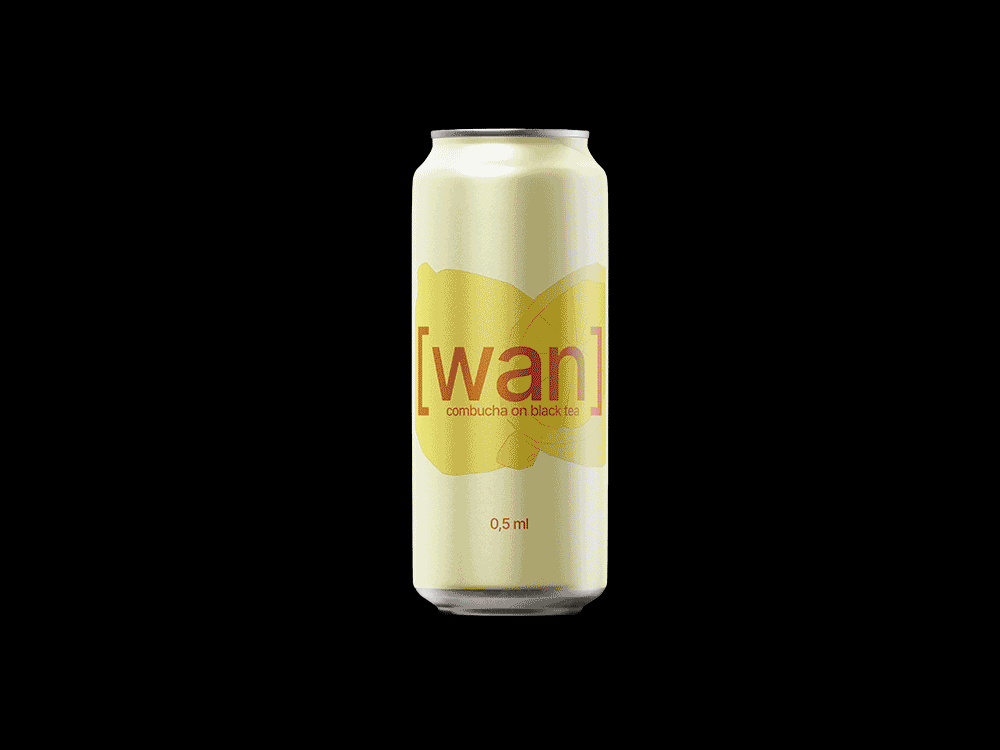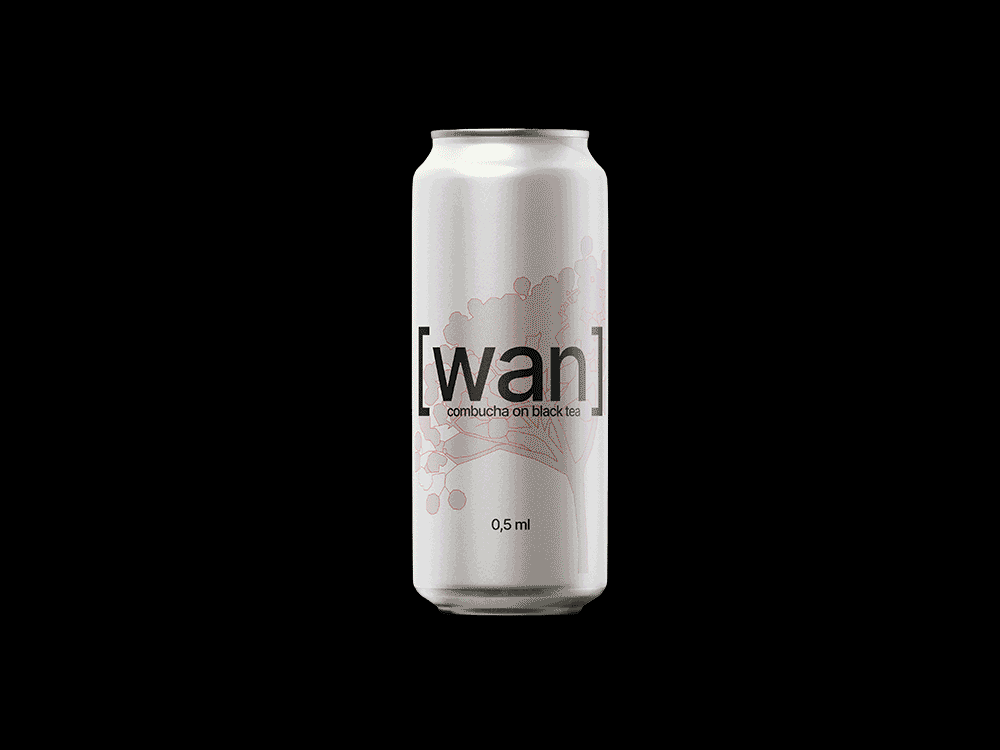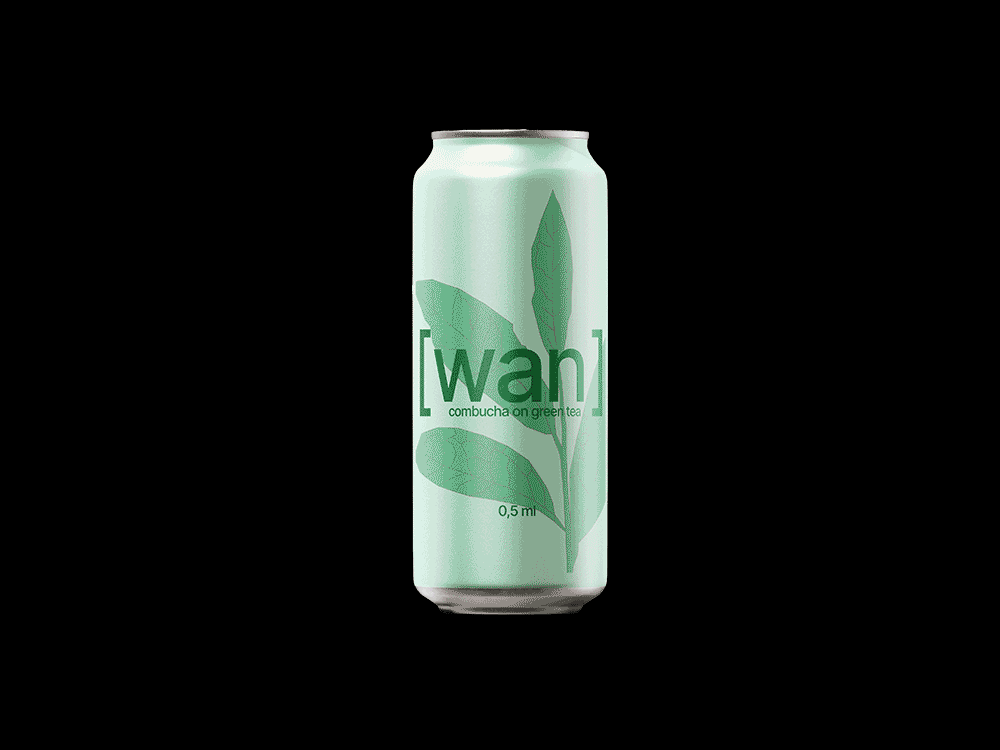
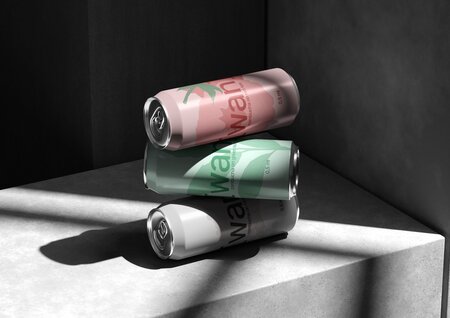
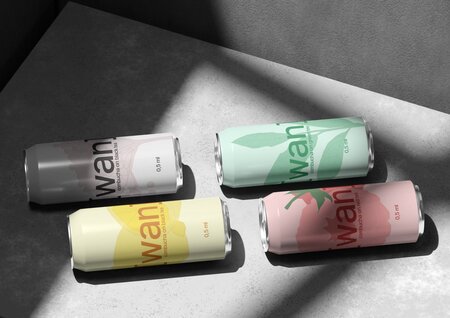
Примеры авторских изображений, использованных для обучения генеративной модели
Для обучения использовался датасет из 11 авторских изображений, созданных в рамках первоначального дизайн-проекта wan. В выборку вошли плоские этикетки разных вкусов, рекламный постер, трёхмерные визуализации упаковки и дополнительные элементы фирменной айдентики.
Основные особенности исходного стиля:
● Мягкая пастельная цветовая палитра.
● Минималистичные композиции и большое количество свободного пространства.
● Геометризированные изображения фруктов и растений.
● Тонкие контурные линии.
● Крупная типографика и технические элементы упаковки: информационные таблицы, штрихкоды, пиктограммы.
Перед обучением все изображения были приведены к квадратному формату 1024 × 1024 пикселей с сохранением исходных пропорций. Для каждого изображения было подготовлено текстовое описание, содержащее характеристики композиции, цветовой гаммы и визуальных элементов. Во все описания был добавлен специальный идентификатор wanstyle, позволяющий обращаться к изученному стилю при генерации.
В качестве базовой модели использовалась Stable Diffusion XL (SDXL), а для её адаптации — технология DreamBooth LoRA (LoRA позволяет обучать небольшое количество дополнительных параметров модели без полного переобучения всех её весов). Процесс выполнялся в Google Colab с использованием библиотеки Hugging Face Diffusers.
Основные параметры обучения:
Обучающий датасет: 11 изображений.
Разрешение обучения: 512 × 512 пикселей.
Количество шагов: 300.
Learning rate: 0.0001.
LoRA rank: 8.
Mixed precision: FP16.
Gradient checkpointing и 8-bit Adam для снижения потребления памяти.
После завершения обучения веса LoRA были сохранены отдельно и подключены к базовой модели SDXL. Для создания итоговой серии использовались текстовые запросы, содержащие идентификатор wanstyle и описание новых объектов, вкусов и композиций.
Результирующие изображения:
Итоговая серия представляет собой экспериментальное расширение визуального мира бренда wan.
Были сгенерированы варианты упаковки с персиком, личи, сливой, жасмином и цитрусовыми мотивами, а также рекламные композиции с несколькими банками комбучи. Особое внимание уделялось сохранению единого визуального характера при изменении сюжетов. В результате получилась коллекция, объединённая пастельной палитрой, растительными мотивами, минималистичной эстетикой и принципами предметной композиции.
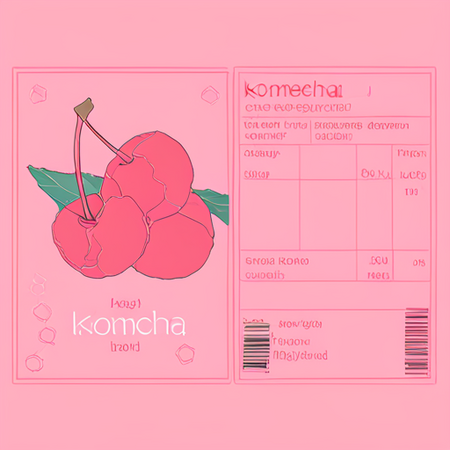
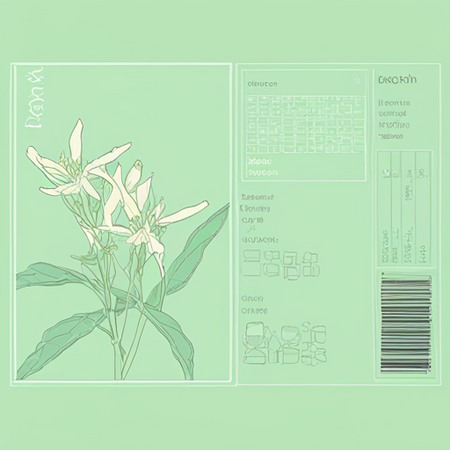
Результирующие изображения:
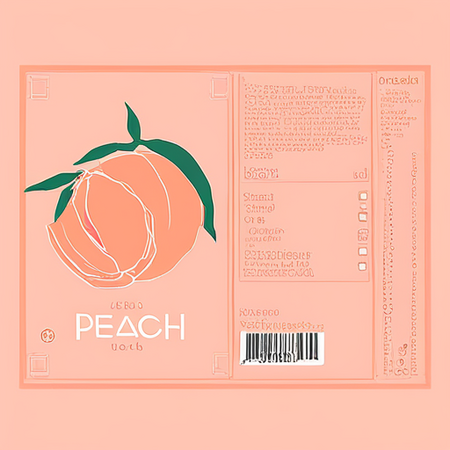
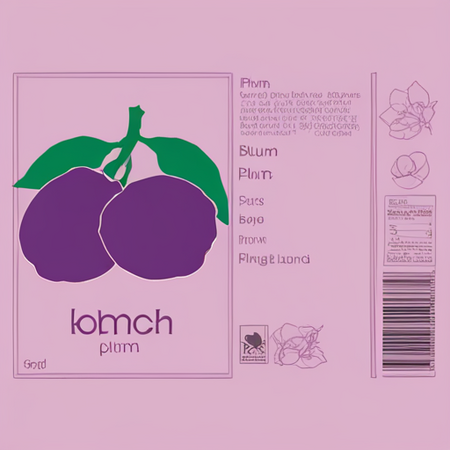
Результирующие изображения:
● Передача авторского стиля
Модель наиболее успешно переняла цветовые и иллюстративные особенности исходного проекта. В генерациях сохранились пастельные оттенки, мягкие цветовые сочетания, тонкие контуры и геометризированные растительные формы. Особенно заметно влияние исходных этикеток в плоских графических композициях, где нейросеть воспроизводит информационные блоки, рамки и элементы технической графики.
● Вариативность изображений
Несмотря на небольшой объём обучающего датасета, модель смогла создавать новые композиции, отличающиеся расположением объектов, цветовыми решениями и форматом представления продукта.
Таким образом, исходная система айдентики получила несколько новых направлений развития.
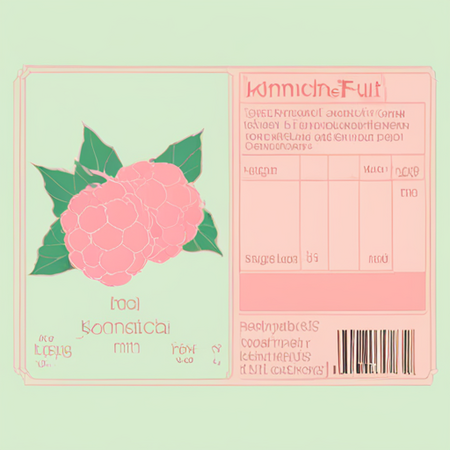
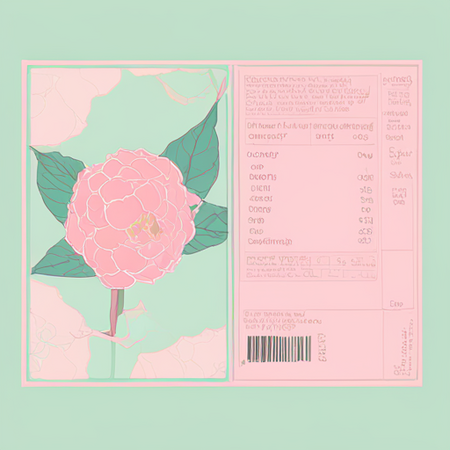
Результирующие изображения (разная этикетка личи):
Основная проблема связана с типографикой.
Нейросеть воспроизводит расположение надписей и их визуальный характер, но часто искажает буквы и создаёт нечитаемый текст. Также не все новые фрукты распознаются достаточно точно: иногда модель заменяет их ботаническими формами, похожими на элементы исходного датасета. Для улучшения результатов использовались уточнённые текстовые запросы, более подробно описывающие форму фруктов, графическую технику и композицию.