Крокотари
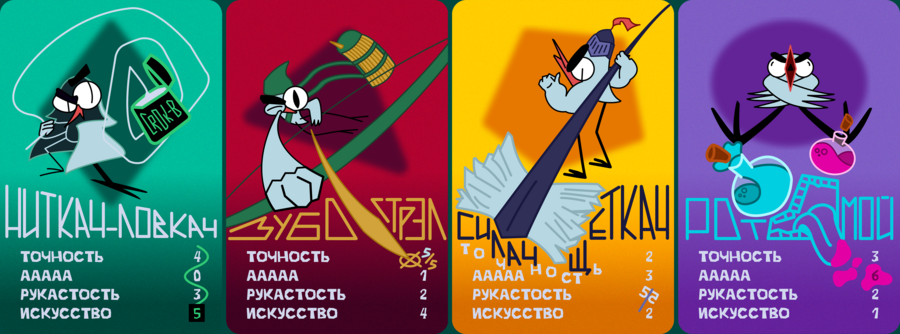
карточки героев
Крокотари — настольная карточная игра с полем. Геймплей строится на разыгрывании 3 колод: персонажи, злодеи и ивенты. Персонажи это 4 стартовые карточки, распределяющиеся между 1-4 возможными игроками. Игровое разнообразие зависит от качества и количества карт злодеев и ивентов. Задача генерации состояла в том, чтобы это разнообразие прокачать
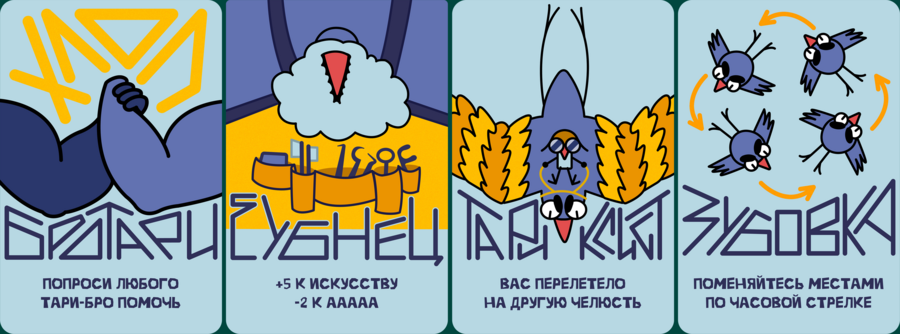
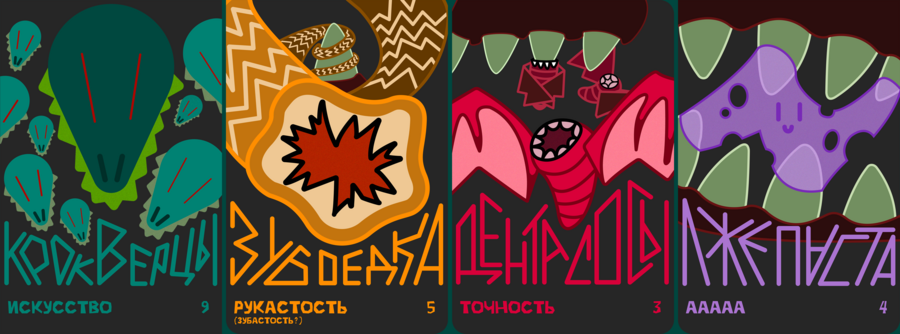
Изначально было вручную отрисовано 12 карт, по 4 в каждой колоде. Они и были использованы для обучения модели
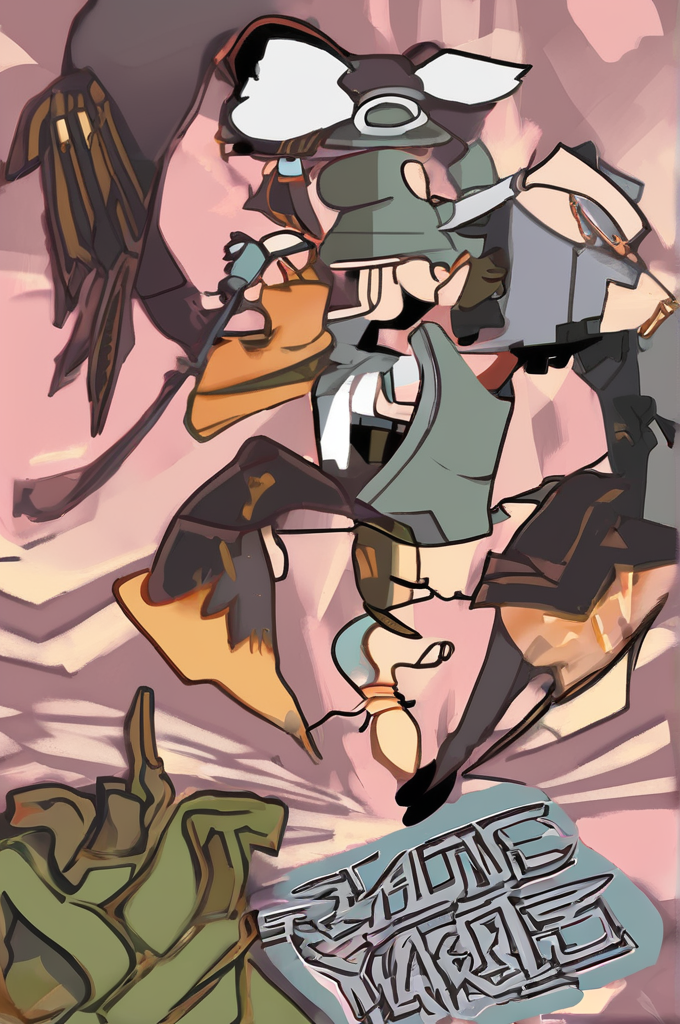
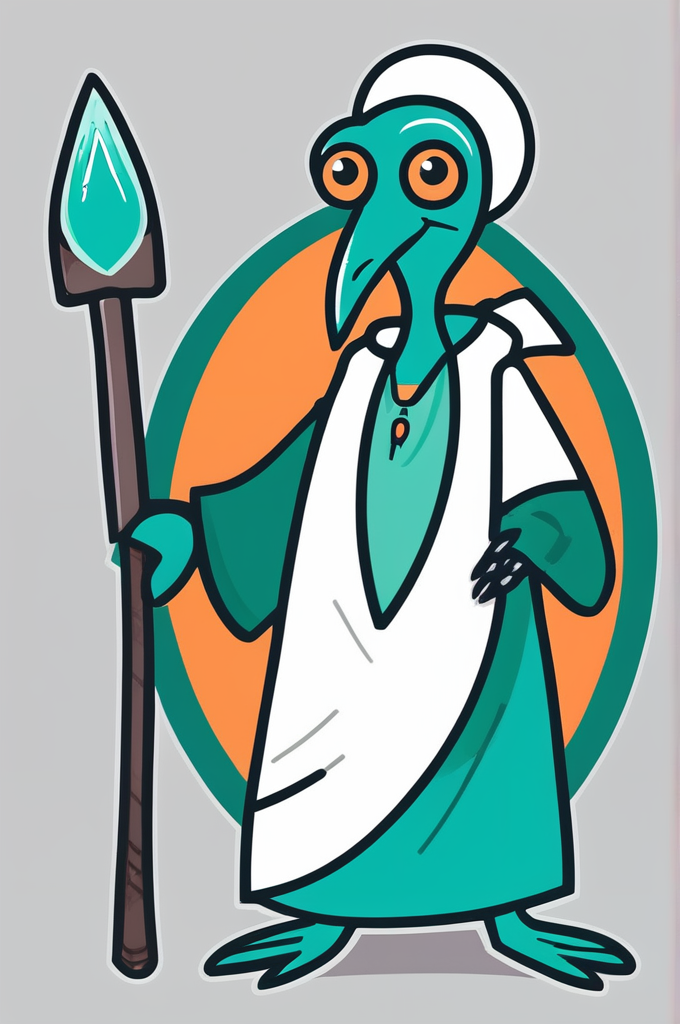
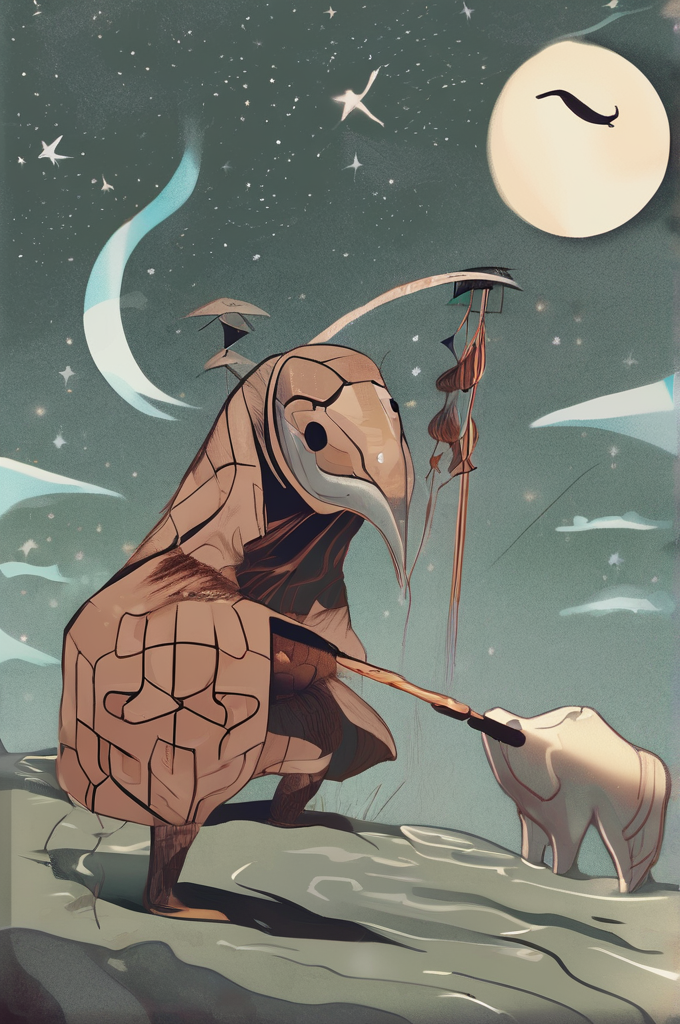
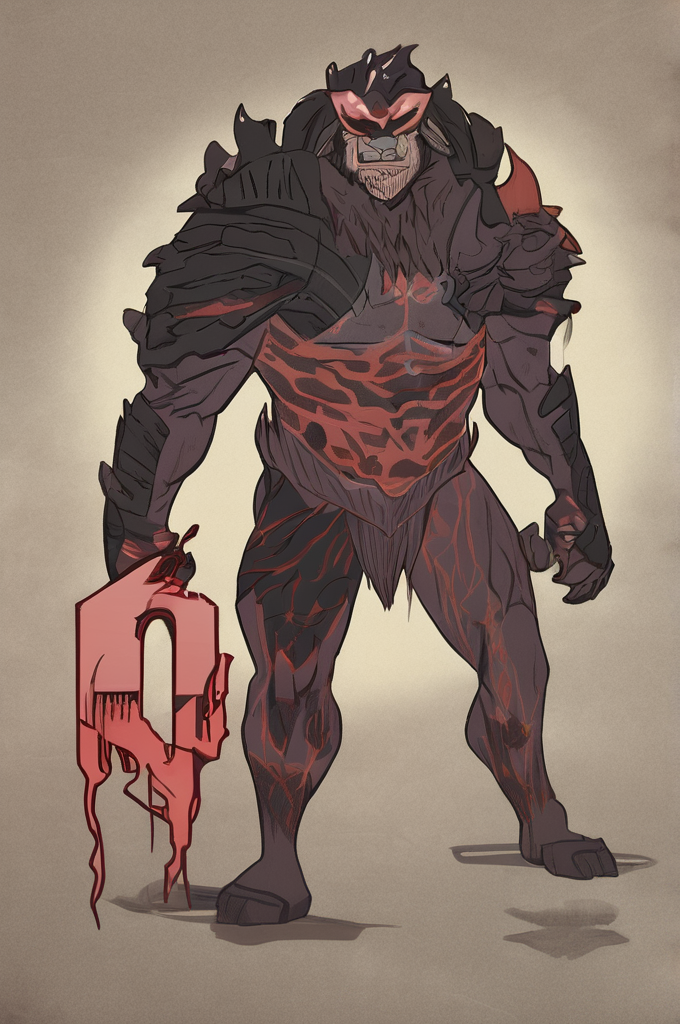
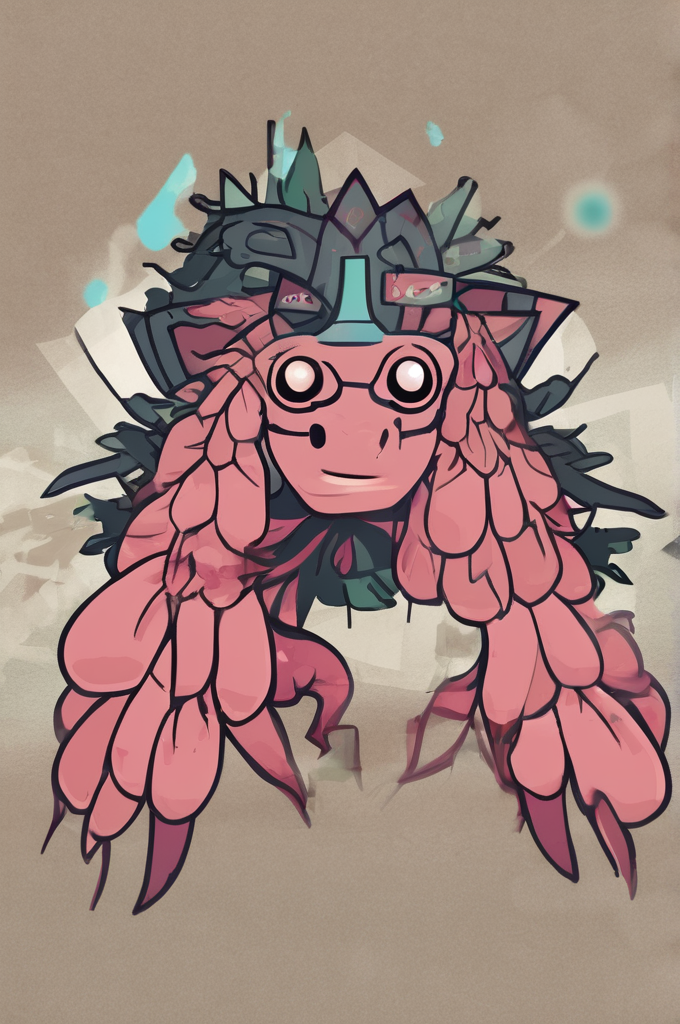
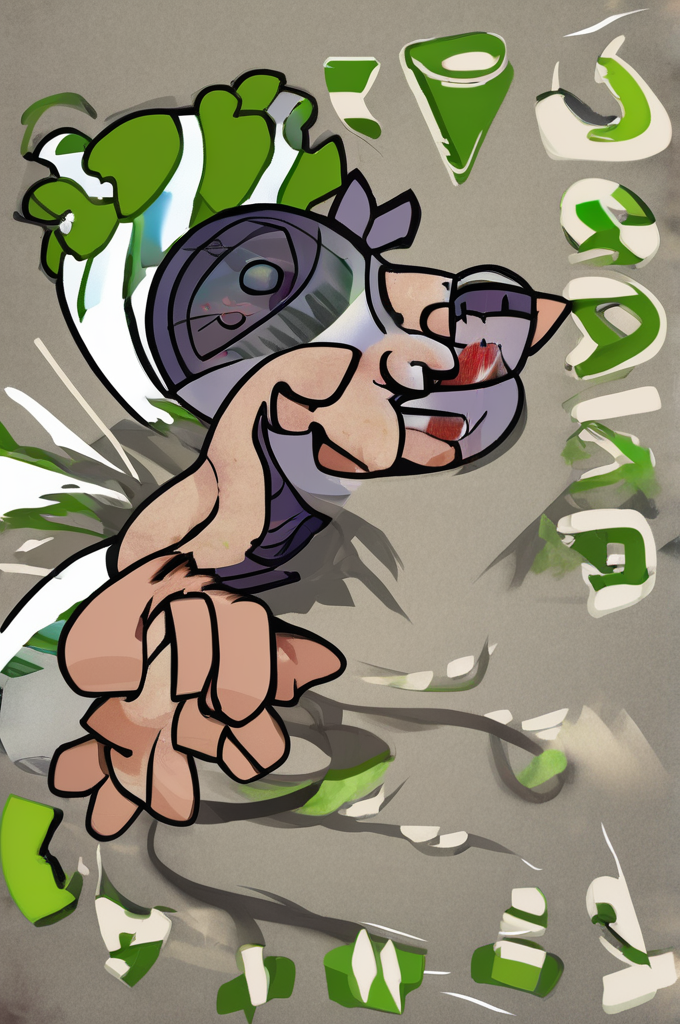
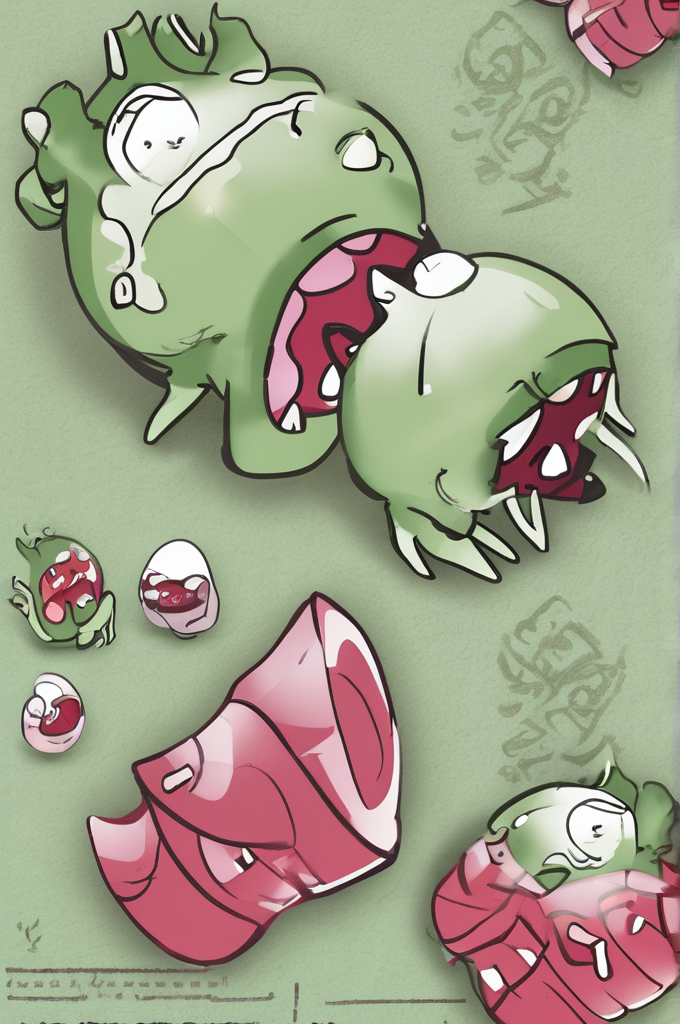
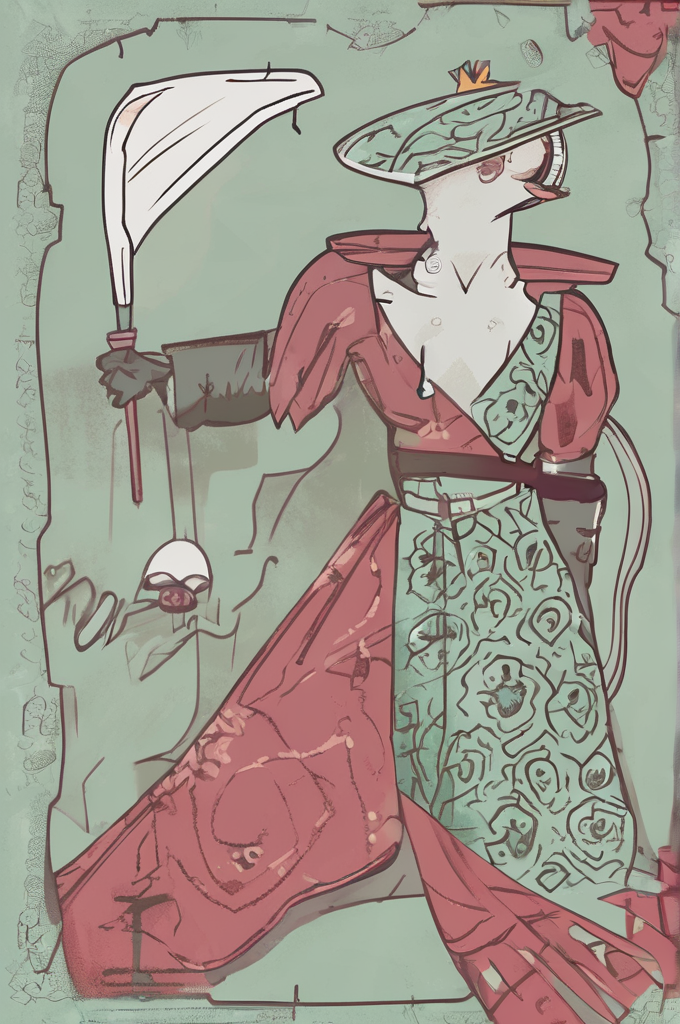
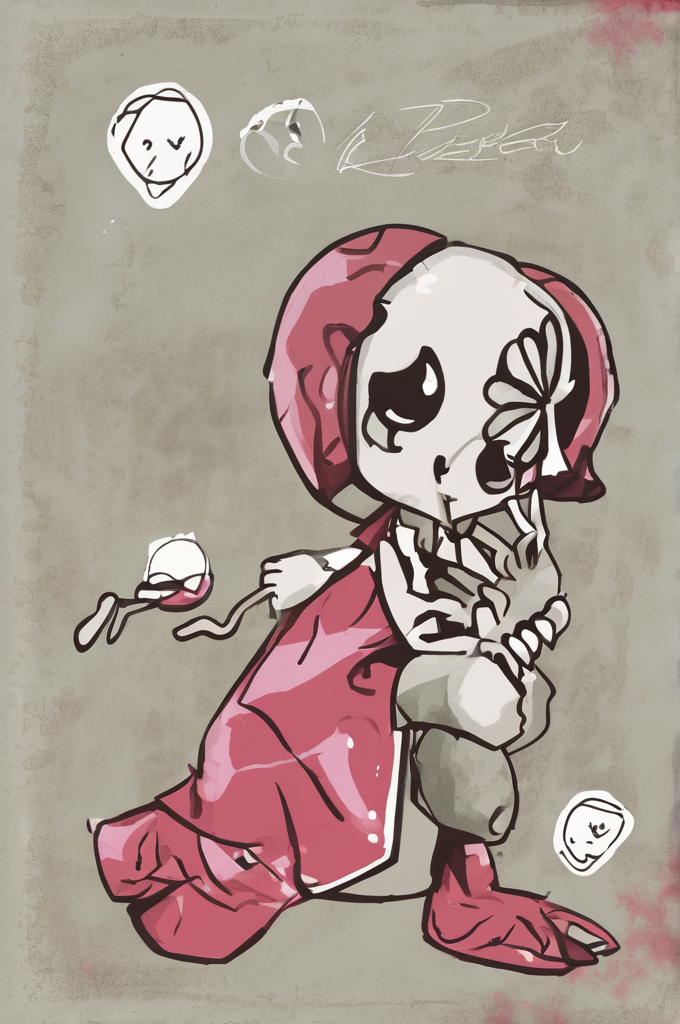
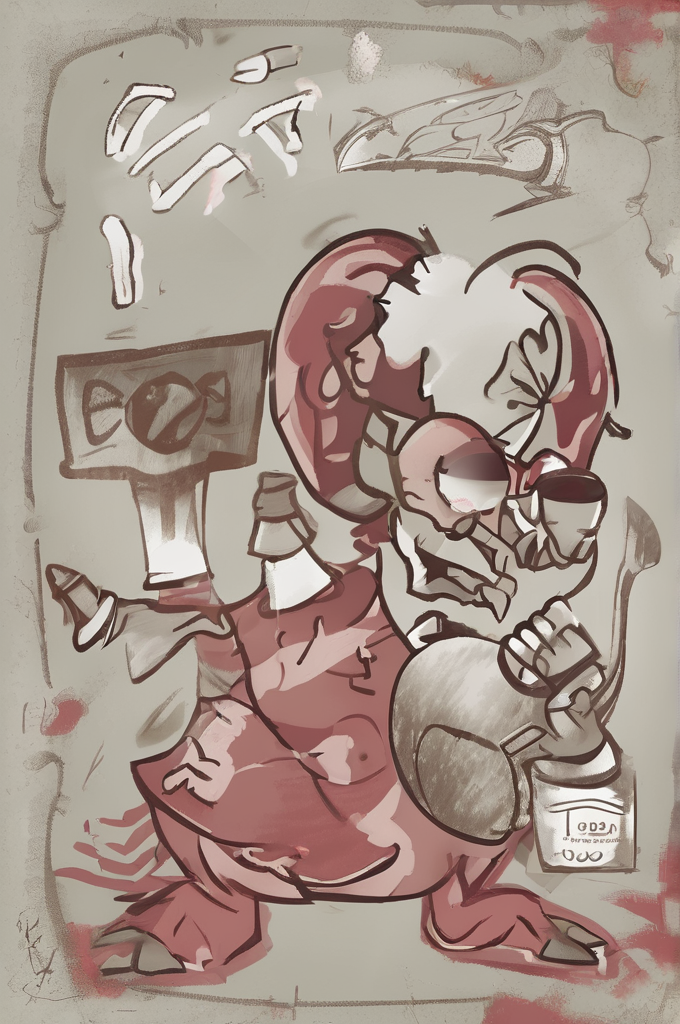
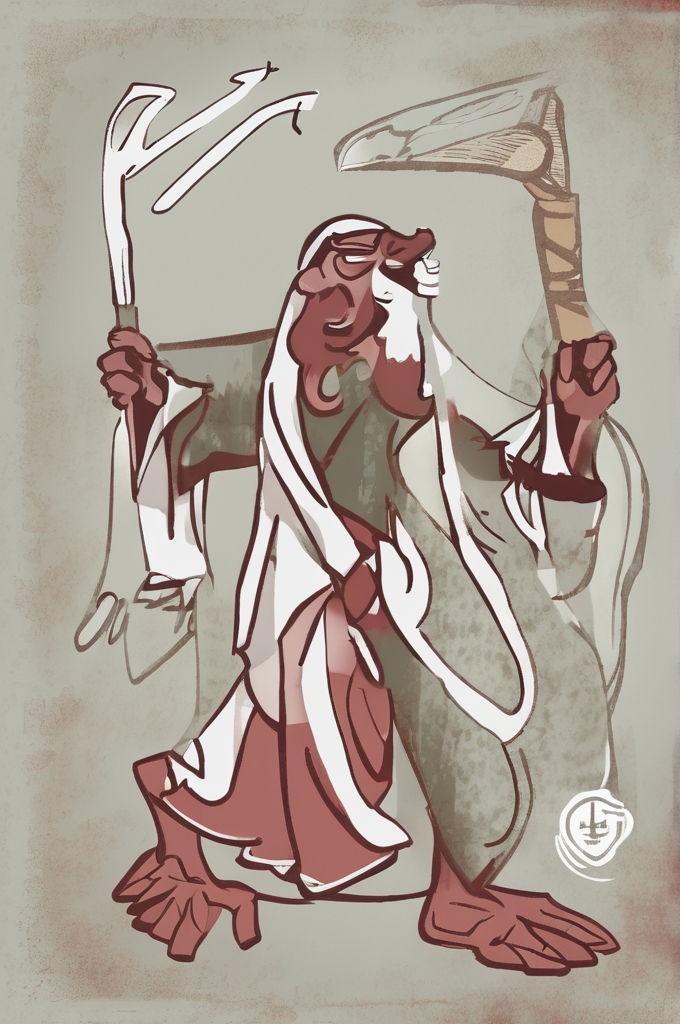
Результат же получился удручающий. Лишь одна из множества генераций действительно чем-то напоминает оригинальный стиль автора. Закрепилсь ключевые графические элементы: толстый лайнарт, комично-крупные глаза, ключевая палитра, однороднвй фон и фокус на персонаже, отцентрованная композиция
описание генеративной модели
Для проекта использовалась Stable Diffusion XL с методом DreamBooth LoRA. Обучение проводилось в Google Colab на GPU Tesla T4 с 16 ГБ видеопамяти. Изображения подгружались из публичной папки на Яндекс.Диске, приведены к формату 1024 × 1024 пикселей и сохранены в JPEG с качеством 95 без цветовой субдискретизации. В качестве базовой модели использовалась stabilityai/stable-diffusion-xl-base-1.0, а в качестве VAE — madebyollin/sdxl-vae-fp16-fix, применённая для предотвращения артефактов цвета при работе в fp16. Разрешение обучения было установлено на 768 × 768 пикселей как компромисс между качеством, на котором обучалась оригинальная SDXL, и лимитом видеопамяти Tesla T4. Обучение шло с train_batch_size = 1 и gradient_accumulation_steps = 4, с включённым gradient_checkpointing для экономии VRAM, с learning rate 1e-4 и планировщиком constant_with_warmup при lr_warmup_steps = 100. Оптимизатором служил 8-bit Adam, mixed precision — fp16. Параметры LoRA: rank = 16, lora_dropout = 0.05, snr_gamma = 5.0. Обучение длилось 500 шагов, промежуточные чекпоинты сохранялись каждые 200 шагов, то есть checkpoint-200 и checkpoint-400, при checkpoints_total_limit = 2 и фиксированном seed = 42. В качестве instance_prompt использовалась фраза «a board game character card in CTEPUNK style», которая затем стала обязательным триггером при генерации.Результатом обучения стал финальный файл весов pytorch_lora_weights.safetensors, а также две промежуточные версии — checkpoint-200/pytorch_lora_weights.safetensors и checkpoint-400/pytorch_lora_weights.safetensors. Все три версии были скопированы на Google Drive в папку CTEPUNK_WISDOM для защиты от сброса среды Colab, поскольку Colab стирает содержимое /content/ при каждом перезапуске рантайма. Генерация с обученной LoRA выполнялась через DiffusionPipeline с загрузкой весов методом load_lora_weights () и их применением через fuse_lora (lora_scale=0.9). В качестве сэмплера использовался DPMSolverMultistepScheduler с use_karras_sigmas=True, что даёт заметно лучшее качество при том же числе шагов. Разрешение генерации — 680 × 1024 пикселей, num_inference_steps = 28, guidance_scale = 7.0. Для работы в пределах 16 ГБ VRAM применялись enable_model_cpu_offload (), vae.enable_tiling () и vae.enable_slicing ().
кроме того, был использован Deep Seek для корректировка кода в Colab и генерации промтов для идей карточек
итог
Нецелесообразно использовать только обученную модель. Для консистентного результата необходимо дообучать модель и корректировать артефакты и детали иными методами генерации.Это интересный метод, с мощными производственным потенциалом, но лишенный ключевого аспекта: веселья!Депрессивное блуждание по строчкам кода, унылая переписка с текстовыми моделями и тут и там вылетающие технические нюансы не стоят лишения себя человеческого брейншторма идей и ручных черканий карандашом/графическим пером.