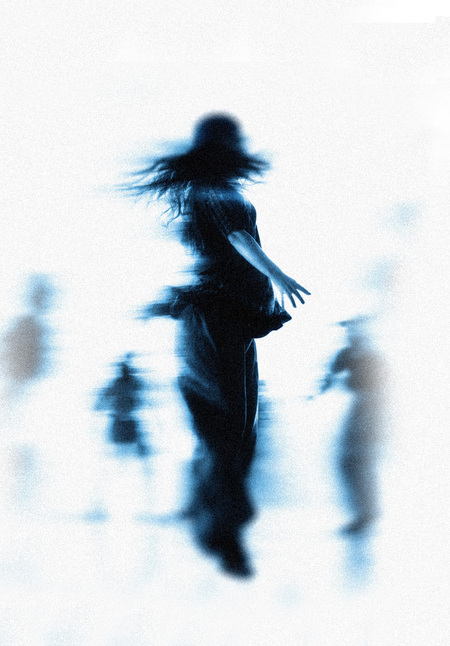
Движение — один из самых выразительных элементов фотографии, особенно в танце. Однако статичный кадр не всегда способен передать пластику, энергию и динамику человеческого тела.Нестандартные способы передачи движения позволяют сделать изображения более эмоциональными и могут использоваться в танцевальной фотографии, музыкальных проектах и рекламе.
Идея проекта — создать необычный стиль обработки с акцентом на размытии и смазе, чтобы подчеркнуть траекторию движений, передать ритм и показать танец как непрерывный процесс.
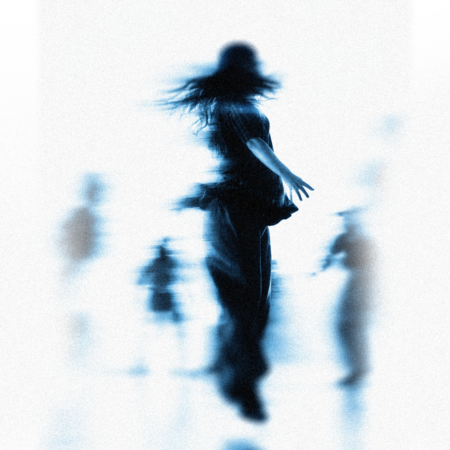
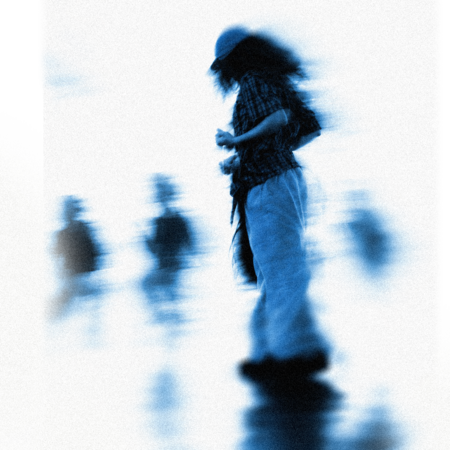
Примеры изображений из авторского датасета, использованного для обучения нейросети и передачи характерных особенностей движения: размытия силуэтов, смаза и динамики человеческого тела.
Задача проекта
Задача проекта — научить нейросеть обрабатывать фотографии предметов в этой актуальной стилистике максимально точно.
Генерация изображений
Для генерации изображений была выбрана нейросетевая модель Stable Diffusion XL, которую необходимо было дообучить для воспроизведения выбранной стилистики размытия движения.Для обучения модели был собран датасет из 25 собственных фотографий, сделанных на танцевальных классах и спортивных занятиях. Все изображения были предварительно обработаны для усиления эффекта смаза и размытия, после чего приведены к квадратному формату 1:1 и использованы для обучения нейросети.
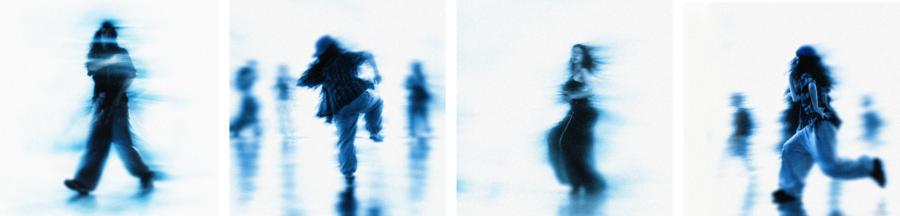
Поскольку основное внимание в проекте было сосредоточено на пластике и динамике отдельного тела в движении, на большинстве фотографий в центре композиции находился один человек. Такой подход позволил точнее обучить модель работе с одиночной фигурой, её силуэтом, траекторией движения и характером смаза. Но также присутствуют фотографии и с группой людей.
Промежуточный результат и оптимизация
Первые генерации были выполнены на промежуточном этапе обучения модели (250 шагов) с силой LoRA 0,5. Нейросеть уже воспроизводила характерное размытие движения, однако при генерации группы танцоров возникали искажения пропорций и анатомии.
При этом уже на данном этапе модель корректно уловила одну из ключевых особенностей выбранной стилистики: более выраженное размытие в движущихся конечностях при сравнительно большей читаемости лица и верхней части фигуры. Это показало, что нейросеть начала распознавать логику распределения смаза внутри изображения и особенности передачи движения в кадре.
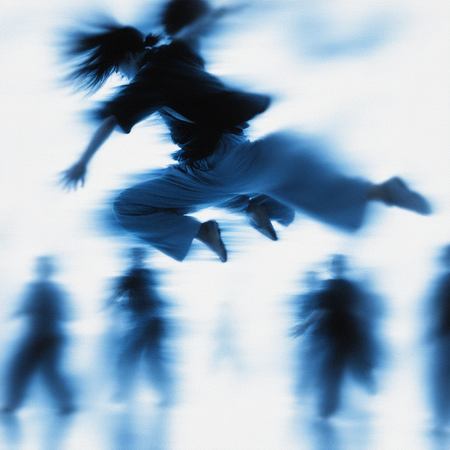
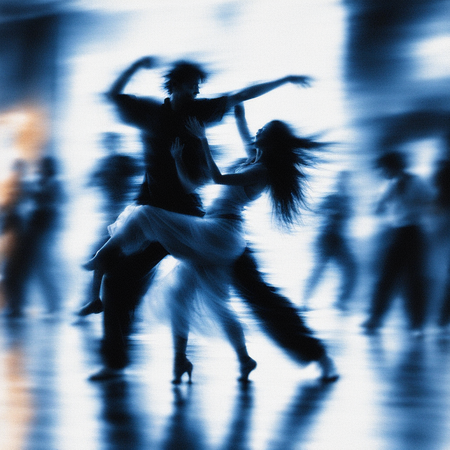
1. a blur of a person jumping in the air 2. a blur of two people dancing in the rain
Для улучшения результата были использованы итоговые веса модели (500 шагов), сила LoRA увеличена до 0,8, а количество шагов генерации — до 35. Также был добавлен негативный промпт для уменьшения анатомических искажений.
В результате модель смогла воспроизвести основные особенности выбранной стилистики: холодную цветовую гамму, светлый размытый фон и характерный смаз движущихся фигур. Размытие наиболее выражено в области рук, ног и волос, тогда как силуэт тела остаётся читаемым. Удалось добиться более естественных пропорций, передать пластику и динамику танца, а также сохранить визуальное единство изображений при разных позах и композициях.
Принцип работы кода
Подготовка данных и среды Код подключает Google Диск и копирует на машину Colab 25 моих фотографий (1), устанавливает библиотеки для работы с нейросетями и скачивает скрипт обучения (2), приводит все фото к единому формату JPG и нумерует их img_01…img_25 (3),
загружает нейросеть BLIP, которая будет автоматически описывать каждое фото (4).
Для каждого фото BLIP создаёт описание, к нему добавляется слово-триггер MYLNITSA. Если подпись зациклилась или слишком длинная, она заменяется на «a blurry photo», для двух кадров подписи я задала вручную. Результат записывается в metadata.jsonl.
Итоговый файл подписей: 25 пар «файл и описание», у каждой в начале слово-триггер. Подписи «a blurry photo» заменили зациклившиеся описания BLIP.
Вход в аккаунт Hugging Face: через него скачивается SDXL и сохраняется моя обученная LoRA.