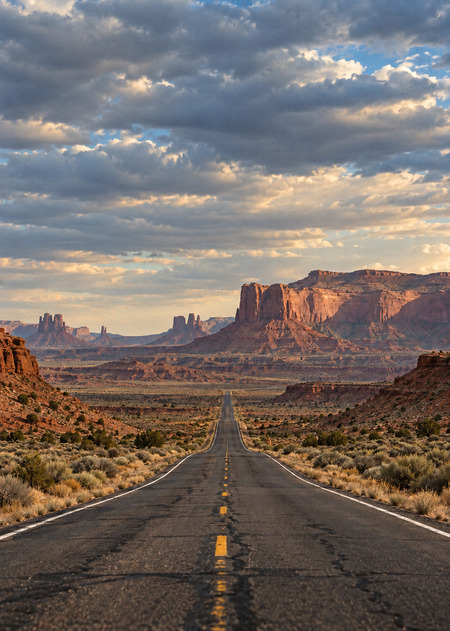
Идея проекта
Во время путешествия по Америке я много фотографировала пейзажи: дороги между скалами, пустынные равнины, каньоны и горные силуэты. В этих кадрах для меня важны не только конкретные места, но и ощущение пути — расстояние, свет и ожидание того, что появится за следующим поворотом.
В проекте «Дорога, которой не было» я использую собственный фотоархив как материал для дообучения генеративной модели. Мне интересно, сможет ли нейросеть перенять визуальные особенности моих фотографий и создать новые пейзажи, которые воспринимаются как продолжение того же путешествия.
Так возникает воображаемый маршрут: его изображения связаны с реальным опытом, но не документируют посещённые мной места.
Исходные фотографии
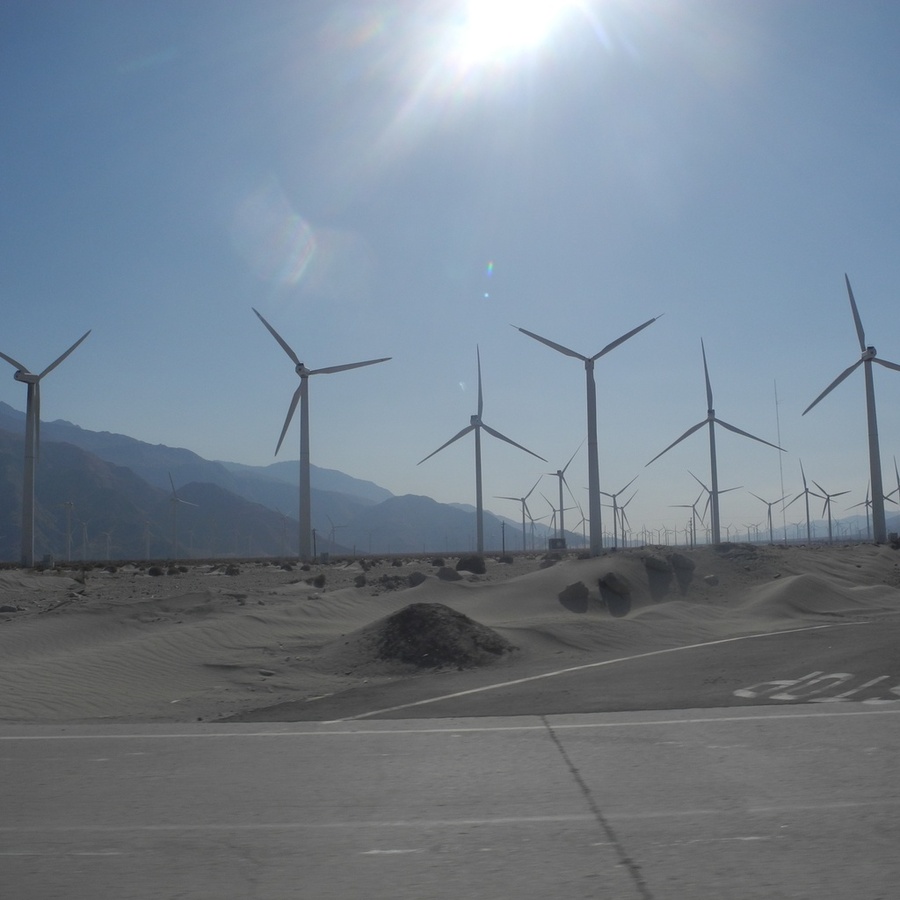
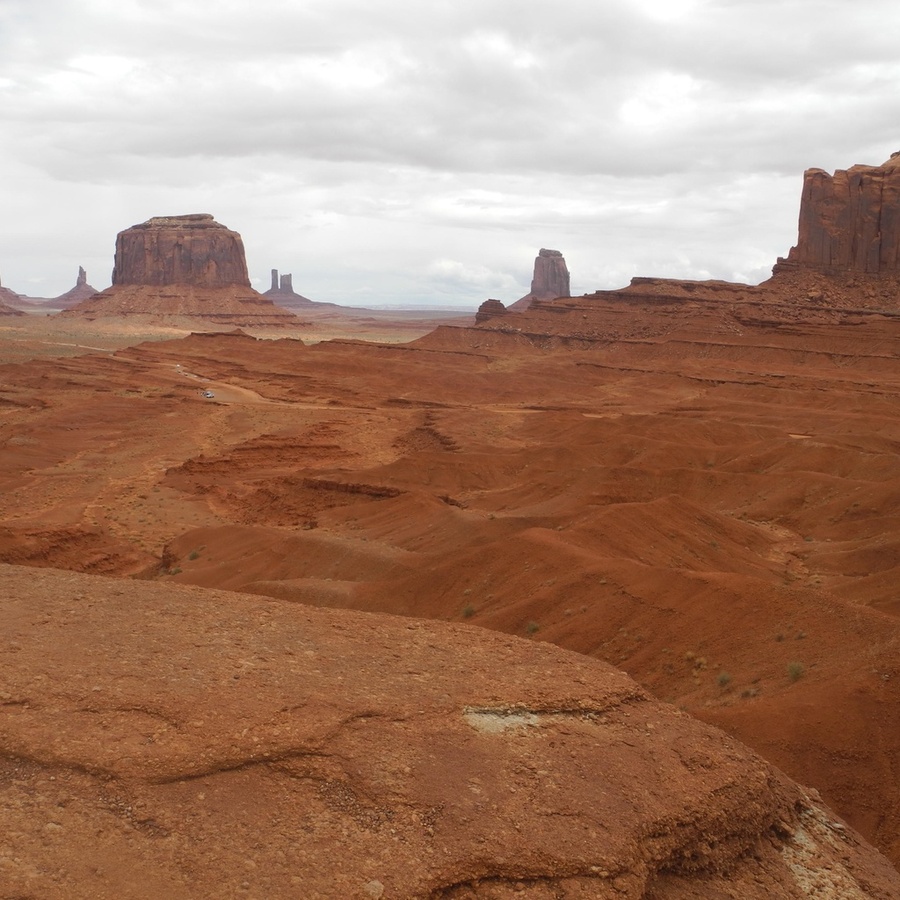
«Авторские фотографии из путешествия. Датасет для обучения».
Для обучения отобраны 16 фотографий из моего американского роад-трипа. В подборку вошли пустынные дороги, красные скалы, каньоны, арки, редкая растительность и отдельные элементы инфраструктуры.
Кадры объединяют повторяющиеся цвета и мотивы: охристая земля, серо-голубое небо, глубокие тени, протяжённые дороги и крупные скальные формы. При этом освещение меняется — от яркого солнца до облачной погоды и заката.
Все исходные фотографии сделаны мной. Для обучения подготовлены квадратные версии размером 1024 × 1024 пикселя без дополнительной цветокоррекции. Каждое изображение сопровождается текстовым описанием сцены.
Метод
В качестве основы используется Stable Diffusion XL. Дообучение выполняется методом LoRA: обучается небольшой набор дополнительных параметров, который затем подключается к базовой модели.Для проекта адаптирован учебный ноутбук курса «Искусственный интеллект для креативных индустрий». В подписях к фотографиям используется общая фраза in alisharoad photographic style, связывающая изображения с выбранной фотографической манерой.Задача эксперимента — проверить, какие особенности исходного архива модель сможет воспроизвести в новых сценах: палитру, освещение, фактуру поверхностей и характер композиции.В учебном ноутбуке я заменила исходный датасет на 16 собственных фотографий американского роад-трипа. Подписи к изображениям подготовлены с помощью Codex вместо автоматического описания моделью BLIP. Обучение выполнено за 300 шагов при разрешении 512 × 512 пикселей. Веса адаптера сохранены на Google Диск.
Настройки обучения
Для дообучения использована модель Stable Diffusion XL Base 1.0 и метод DreamBooth LoRA. Датасет составили 16 авторских фотографий из путешествия по Америке. Обучение выполняется в Google Colab на видеокарте NVIDIA Tesla T4 при разрешении 512 × 512 пикселей.
Число шагов обучения — 300, со скоростью обучения 0,0001 и рангом LoRA 4. Размер пакета составляет одно изображение, а градиенты накапливаются за четыре итерации перед обновлением параметров. Для воспроизводимости эксперимента задан seed 42.
Сравнение до и после обучения
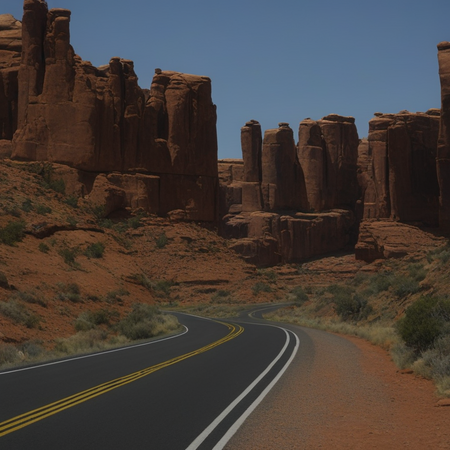
Слева — результат базовой SDXL, справа — результат с обученным адаптером LoRA. Использованы одинаковый текстовый запрос и seed 100.
Итоговая серия
Анализ результатов
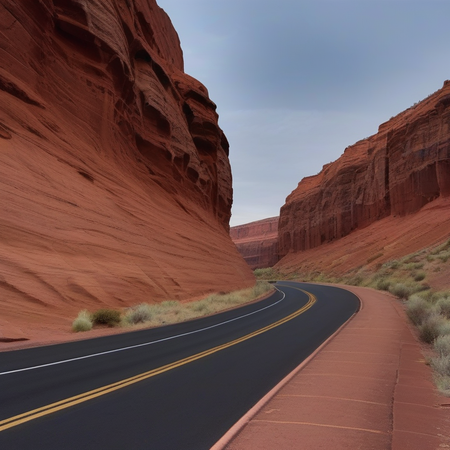
В итоговой серии повторяются мотивы моего фотографического архива: пустынные дороги, красные скалы, каньоны и редкая растительность. Изображения объединяют охристые оттенки, приглушённое небо и глубокие тени.В контрольной паре после подключения LoRA изображение стало темнее, а цвет скал — более сдержанным. Вместо сплошных скальных стен появились отдельные массивы и башни. Эти изменения визуально сближают результат с моими фотографиями. Однако одна контрольная пара не позволяет распространить этот вывод на любые запросы.Серия передаёт разные впечатления от путешествия: дорога создаёт ощущение движения, каньон — масштаба и замкнутости, ветряки — дистанции, закат — завершения маршрута. Так складывается воображаемое продолжение реальной поездки.У эксперимента есть ограничения. Некоторые композиции близки к обучающим фотографиям, особенно сцены с изгибом реки, аркой и закатом. В двух изображениях появились незапрошенные человеческие фигуры, а отдельные детали ветряков выглядят неправдоподобно. Поэтому результат требует визуального отбора и не обеспечивает полного контроля над содержанием.Изображения сгенерированы в разрешении 768 × 768 пикселей за 25 шагов, с guidance scale 6 и силой LoRA 0,8. Для серии использованы seed от 100 до 107.
Описание применения генеративной модели